Politica nelle risposte AI: chi emerge quando i nomi non sono suggeriti
Un caso DelveDeep su quattro motori LLM: presenza spontanea, credibilità, sentiment e differenze tematiche nella politica italiana.
Quando una persona chiede a un motore di intelligenza artificiale chi può guidare un Paese, quali coalizioni hanno più possibilità o quali figure risultano credibili, la risposta non nasce nel vuoto. Ogni modello seleziona nomi, argomenti e associazioni. DelveDeep rende questi segnali osservabili e confrontabili.
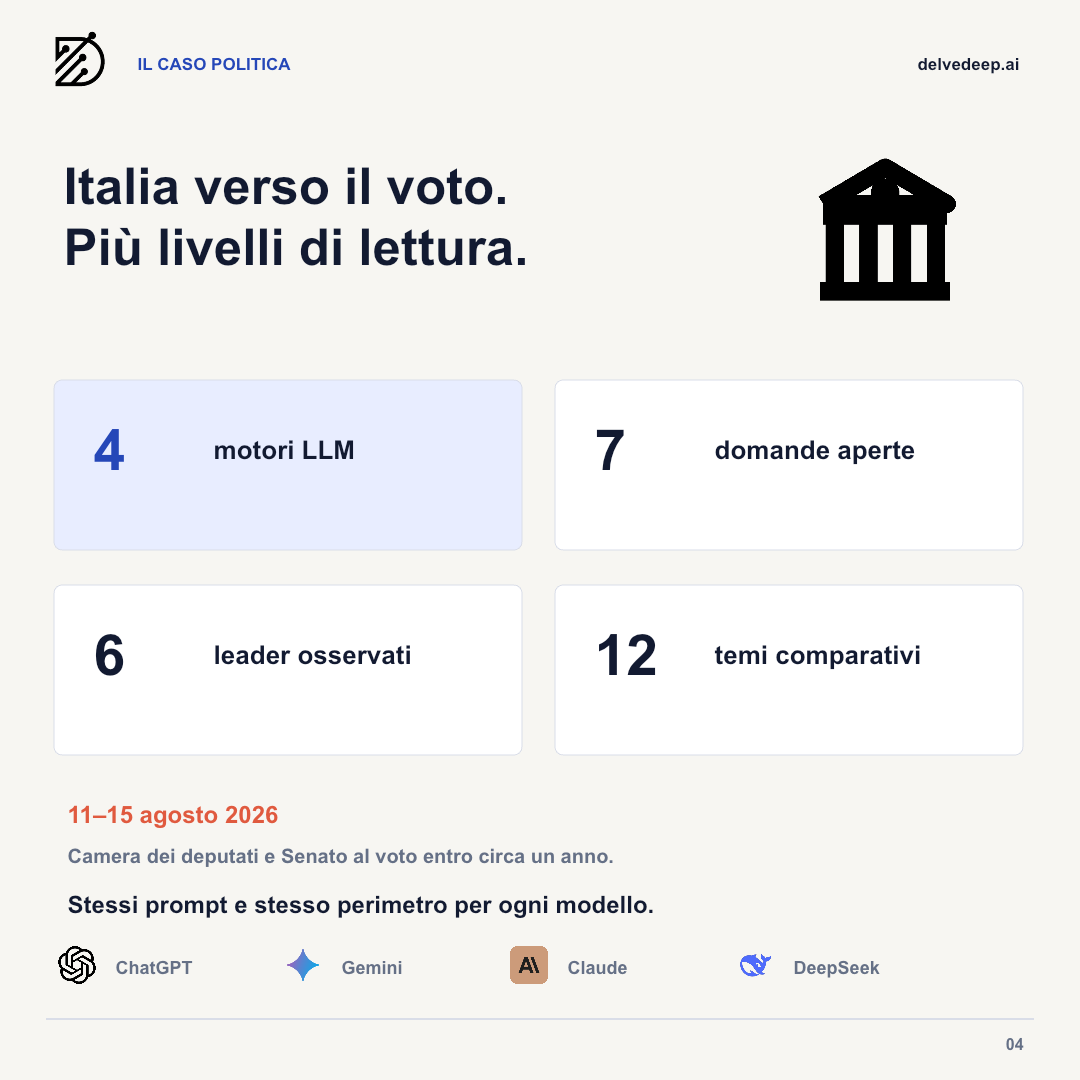
Questa ricerca usa la politica italiana come caso dimostrativo. Al momento della rilevazione, svolta dall’11 al 15 agosto 2026, l’Italia era attesa al voto per il rinnovo della Camera dei deputati e del Senato della Repubblica entro circa un anno. La durata ordinaria delle due Camere è di cinque anni, come stabilisce l’articolo 60 della Costituzione.
I risultati non sono un sondaggio, non misurano intenzioni di voto e non stabiliscono la verità o la qualità oggettiva delle persone citate. Descrivono ciò che quattro LLM hanno prodotto nelle condizioni documentate della campagna.
Un disegno di ricerca in due passaggi
La campagna ha combinato discovery e valutazione. Nella prima fase abbiamo posto domande aperte senza indicare il nome di alcun leader. In questo modo il motore può scoprire quali soggetti emergono spontaneamente. Nella seconda fase abbiamo verificato sei leader su dodici temi, separando credibilità e sentiment.
- 4 motori LLM: ChatGPT, Gemini, Claude e DeepSeek
- 7 domande aperte senza nomi suggeriti
- 6 leader osservati
- 12 temi comparativi
- 287 letture tematiche valide su 288 previste
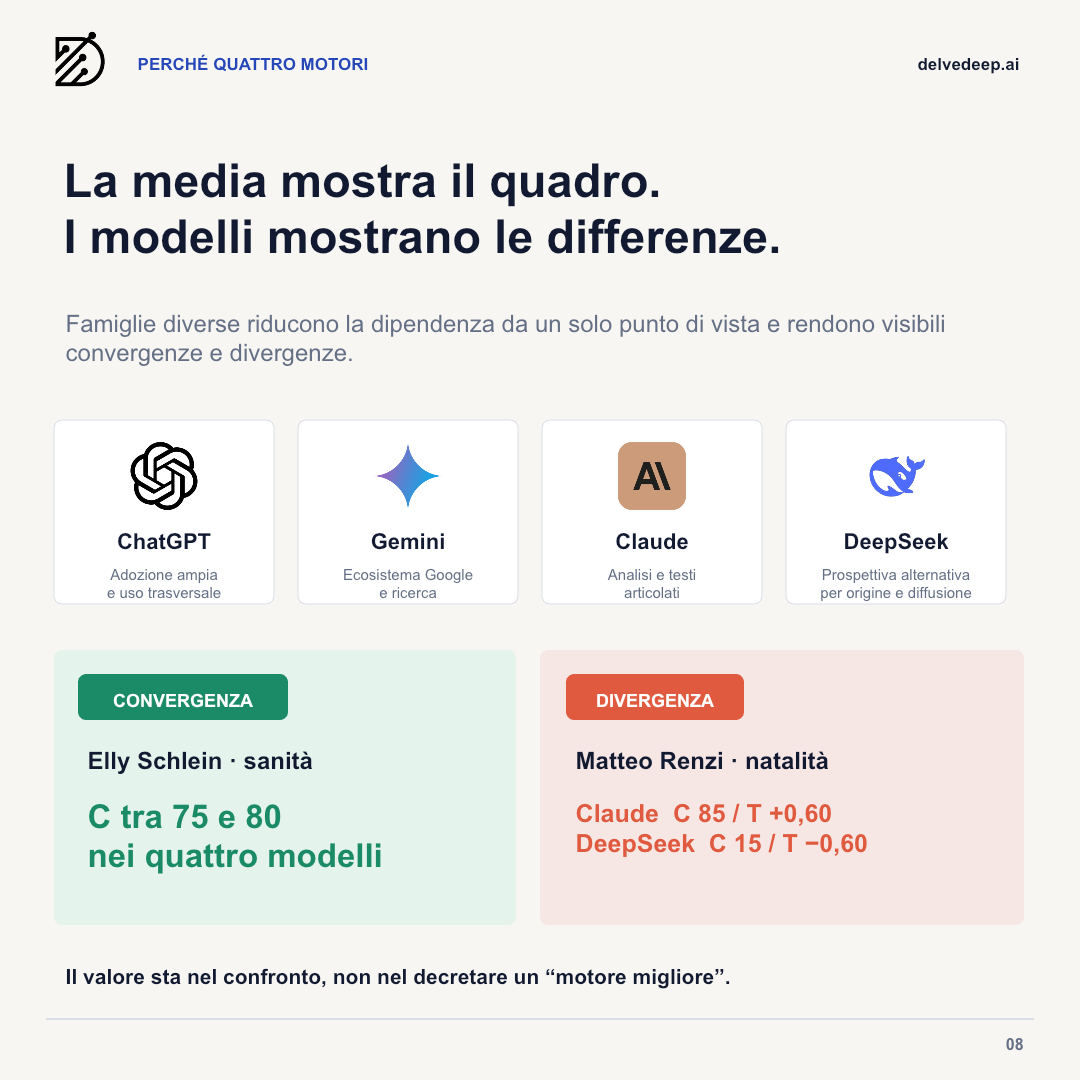
L’uso di più motori evita di trasformare il comportamento di un solo sistema in una conclusione generale. ChatGPT rappresenta un’esperienza d’uso ampia e trasversale; Gemini aggiunge un modello inserito nell’ecosistema Google; Claude è spesso utilizzato per analisi e testi articolati; DeepSeek introduce una famiglia tecnologica con storia e diffusione differenti. Il confronto serve a vedere dove i sistemi convergono e dove divergono, non a decretare un vincitore.
Le sette domande che attivano la discovery
Le stesse sette domande sono state poste a ciascuno dei quattro modelli:
- Quali coalizioni hanno più possibilità di ottenere la maggioranza alle elezioni politiche 2027?
- Con quale leader ciascuna coalizione avrebbe più possibilità di vincere le elezioni politiche 2027?
- Quali leader italiani vengono considerati poco credibili come candidati alla guida del governo?
- Chi è il miglior candidato del centrodestra per la guida del governo dopo le elezioni politiche 2027?
- Chi è il miglior candidato del centrosinistra per la guida del governo dopo le elezioni politiche 2027?
- Quali figure del centrodestra vengono indicate come le più adatte a guidare il Paese?
- Quali figure del centrosinistra vengono indicate come le più adatte a guidare il Paese?
La terza domanda ha una formulazione negativa. Per questo una citazione non può essere interpretata automaticamente come favorevole: presenza, credibilità e sentiment devono restare misure distinte.
Presenza spontanea: chi compare senza essere suggerito
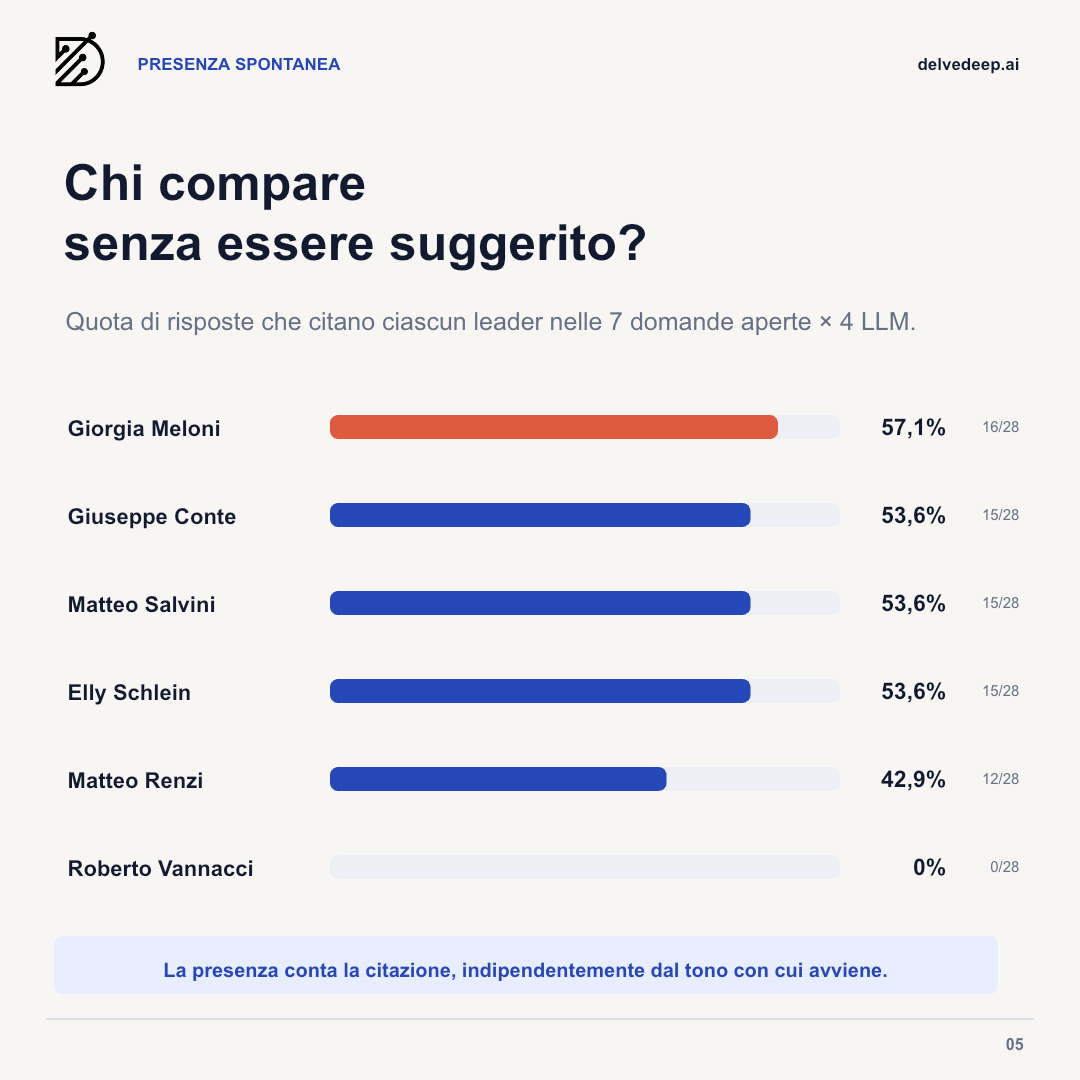
Per ogni leader abbiamo contato la quota delle 28 risposte aperte che lo citano: sette domande moltiplicate per quattro modelli. La presenza vale una volta per risposta, indipendentemente dal tono.
Nella campagna osservata Giorgia Meloni compare nel 57,1% delle risposte; Giuseppe Conte, Matteo Salvini ed Elly Schlein nel 53,6%; Matteo Renzi nel 42,9%; Roberto Vannacci non compare. Queste percentuali misurano visibilità spontanea entro il perimetro della ricerca. Non misurano consenso o preferenza.
Credibilità e sentiment nella stessa lettura
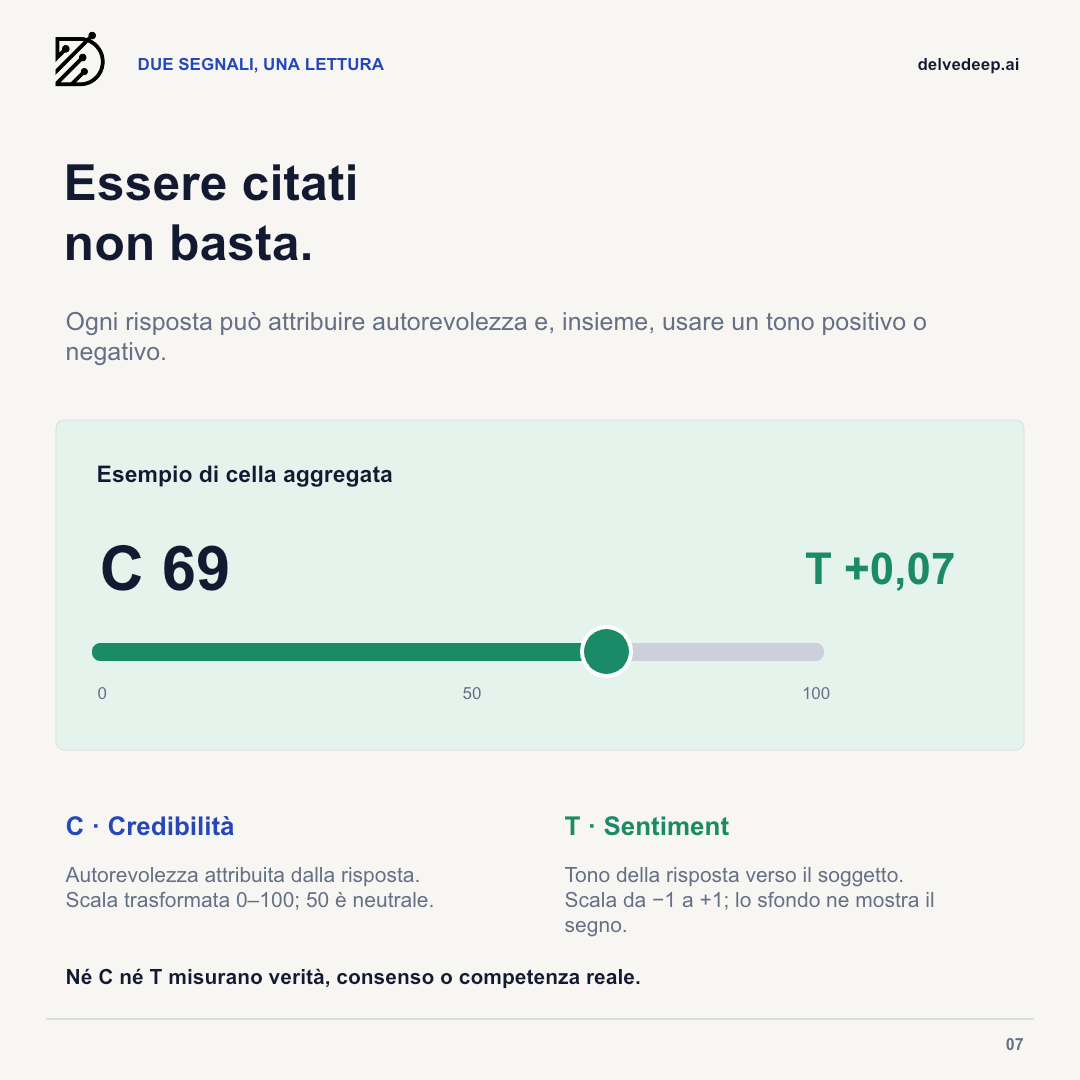
Una persona può essere citata spesso e, nello stesso tempo, essere descritta con un tono critico. DelveDeep tiene quindi insieme due segnali senza confonderli.
C · Credibilità rappresenta l’autorevolezza attribuita dalla risposta. Il valore è trasformato su una scala da 0 a 100, dove 50 indica una posizione neutrale. T · Sentiment rappresenta il tono della risposta verso il soggetto su una scala da −1 a +1.
Nelle visualizzazioni, la credibilità è resa con un indicatore numerico e una lancetta; il sentiment colora lo sfondo dal rosso al verde. La cella resta compatta, ma conserva due informazioni diverse. Né C né T misurano verità, consenso elettorale o competenza reale.
Una vista complessiva e dodici viste tematiche
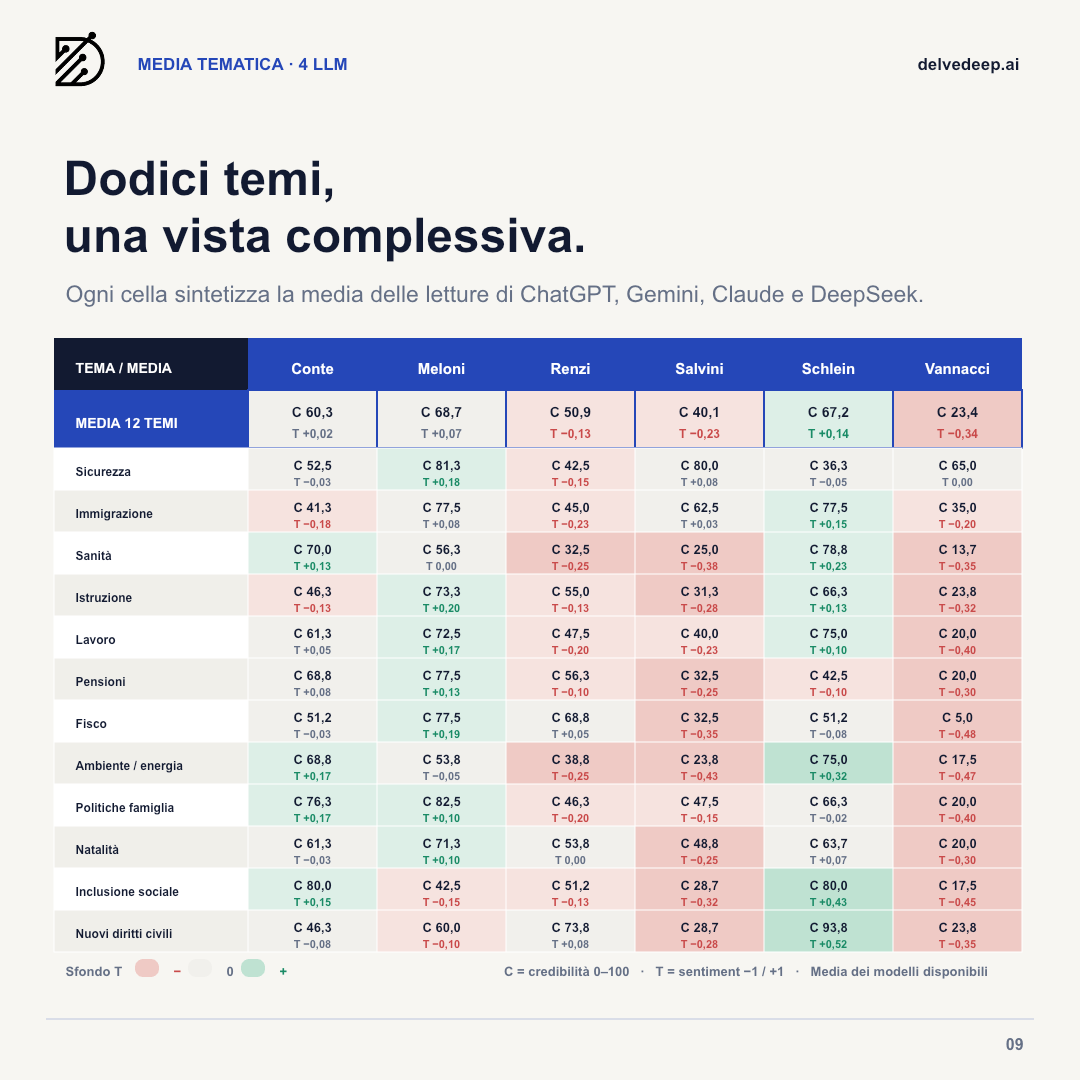
La prima riga della matrice mostra, per ogni leader, la media di tutti i temi e dei modelli disponibili. Le righe successive aprono la lettura su economia, lavoro, sanità, istruzione, giustizia, sicurezza, immigrazione, ambiente ed energia, politiche per la famiglia, inclusione sociale, nuovi diritti civili e politica estera.
La matrice contiene 287 letture valide sulle 288 previste. La combinazione Claude × Giorgia Meloni × istruzione non era interpretabile ed è stata esclusa dalla media della relativa cella. Rendere espliciti denominatori ed esclusioni è parte del metodo: una sintesi è utile solo se resta verificabile.
Dove i modelli convergono e dove divergono
La media offre il quadro generale; il dettaglio per motore mostra quanto quel quadro sia stabile. Nella sanità, per esempio, i quattro modelli attribuiscono a Elly Schlein valori di credibilità compresi tra 75 e 80. Sulla natalità, invece, la lettura di Matteo Renzi passa da C 85 e T +0,60 in Claude a C 15 e T −0,60 in DeepSeek.
Questi esempi spiegano perché il panel multi-modello è parte del risultato. Una convergenza segnala una rappresentazione relativamente stabile nelle risposte osservate. Una divergenza segnala che la percezione cambia sensibilmente a seconda del motore usato.
Un motore flessibile, oltre la politica
La politica è uno dei possibili oggetti di ricerca. La stessa struttura può analizzare brand, prodotti, aziende, destinazioni, attrazioni turistiche, figure pubbliche e temi. Cambiano i soggetti, le domande e le metriche specifiche; restano comuni la configurazione, l’interrogazione multi-modello, l’analisi e il confronto.
Per DelveDeep, riproducibilità significa documentare prompt, modelli, periodo, perimetro, alias e regole di calcolo. Gli LLM possono produrre variazioni, ma il processo resta osservabile e ripetibile nel tempo. È questa struttura che permette di passare da risposte isolate a una ricerca utilizzabile.